Cómo leer EXPLAIN ANALYZE en PostgreSQL sin perderse en el plan
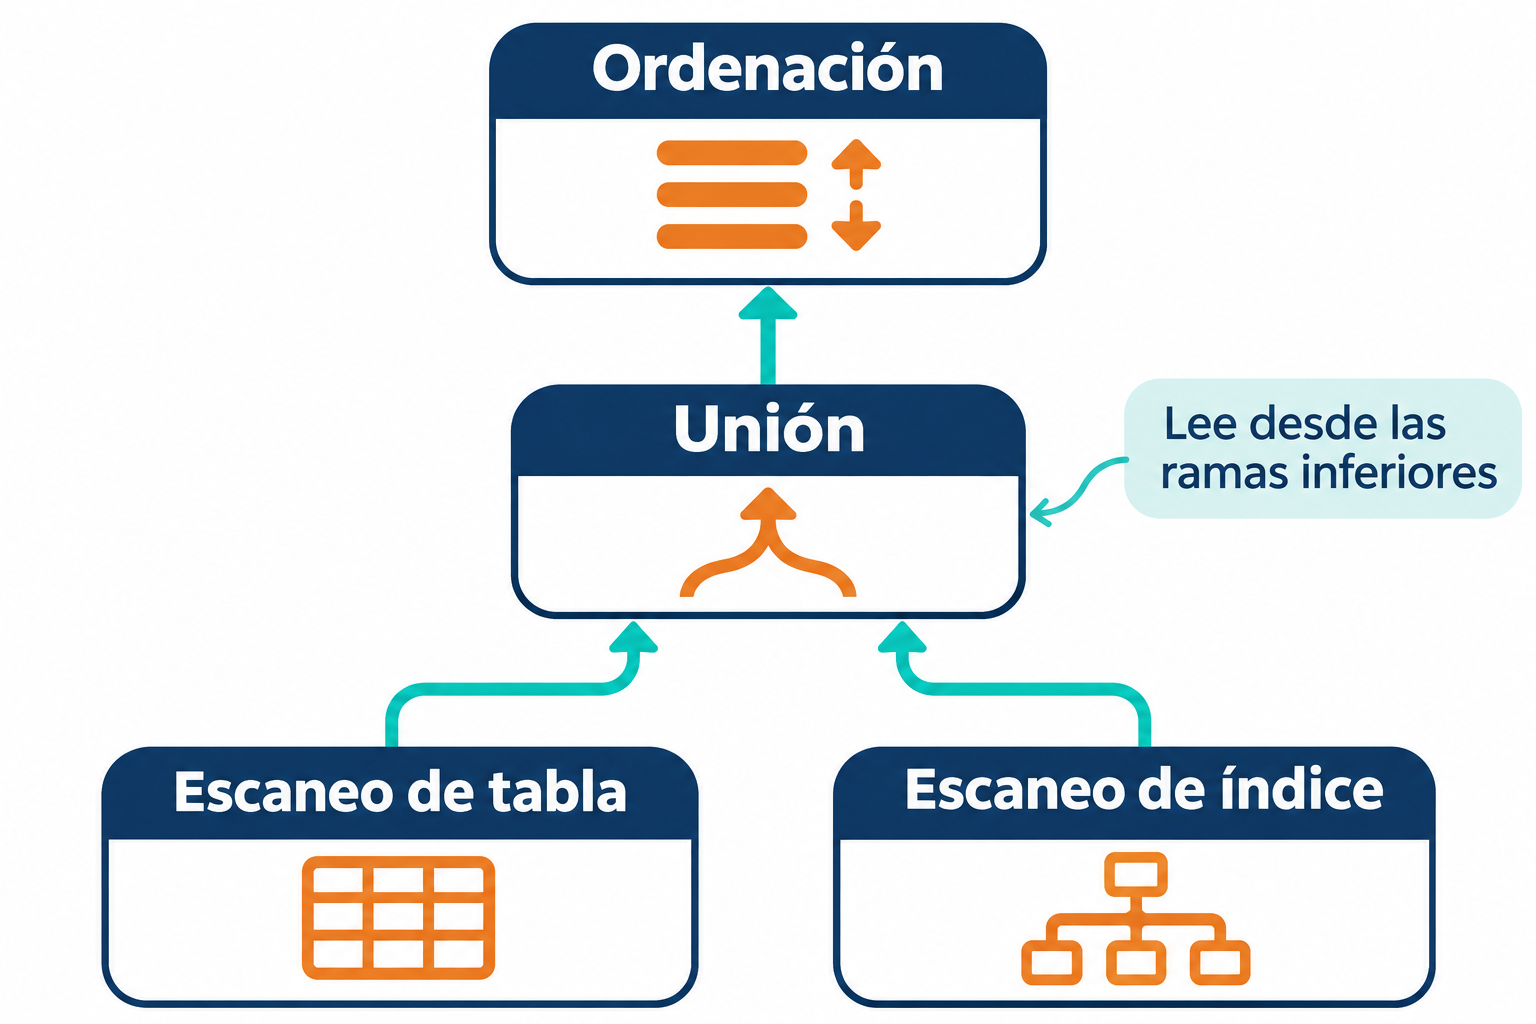
Un plan de ejecución se entiende mejor como un árbol que como una lista de líneas. Una forma práctica de leerlo es empezar por las ramas inferiores, seguir las filas hacia arriba y comparar las estimaciones con lo que ocurrió durante la ejecución.
Esta guía se refiere a PostgreSQL 18. La secuencia de lectura es una recomendación práctica y las cifras del plan son hipotéticas. Los extractos documentales incluidos son los aportados en la investigación; no se han abierto las páginas para verificarlos de forma independiente.
Antes de empezar: ANALYZE ejecuta la sentencia
EXPLAIN ANALYZE ejecuta la sentencia y sus efectos secundarios ocurren normalmente. En la sección Description, la referencia advierte: «other side effects of the statement will happen as usual». Para probar sentencias que modifican datos, propone usar BEGIN, EXPLAIN ANALYZE y ROLLBACK. Como precaución, no des por hecho que ROLLBACK revierta cualquier efecto externo o de una función concreta: eso no se ha comprobado para una instalación determinada.
Para observar la actividad sobre bloques, puedes anteponer EXPLAIN (ANALYZE, BUFFERS) a la consulta. En PostgreSQL 18, la sección 14.1.2 de Using EXPLAIN indica que «ANALYZE option implicitly enables the BUFFERS option» y muestra cómo desactivarlo con EXPLAIN (ANALYZE, BUFFERS OFF).
1. Recorre el árbol desde abajo
La sección 14.1.1 de la guía oficial describe el plan como «a tree of plan nodes»: un árbol de nodos. Los escaneos inferiores suministran filas y los nodos superiores pueden unirlas, agregarlas u ordenarlas. Una manera de seguir el plan es recorrer cada rama hacia arriba y preguntarse qué recibe y qué produce cada operación.
2. Reconoce las métricas en un plan
El siguiente ejemplo es hipotético: sus cifras se han inventado para ilustrar la lectura y no proceden de una ejecución.
- Nodo padre: Nested Loop; cost=0.00..20.00, filas estimadas=10; actual time=0.020..0.100, filas reales=10, loops=1.
- Primer hijo: Seq Scan on a; cost=0.00..5.00, filas estimadas=10; actual time=0.010..0.030, filas reales=10, loops=1.
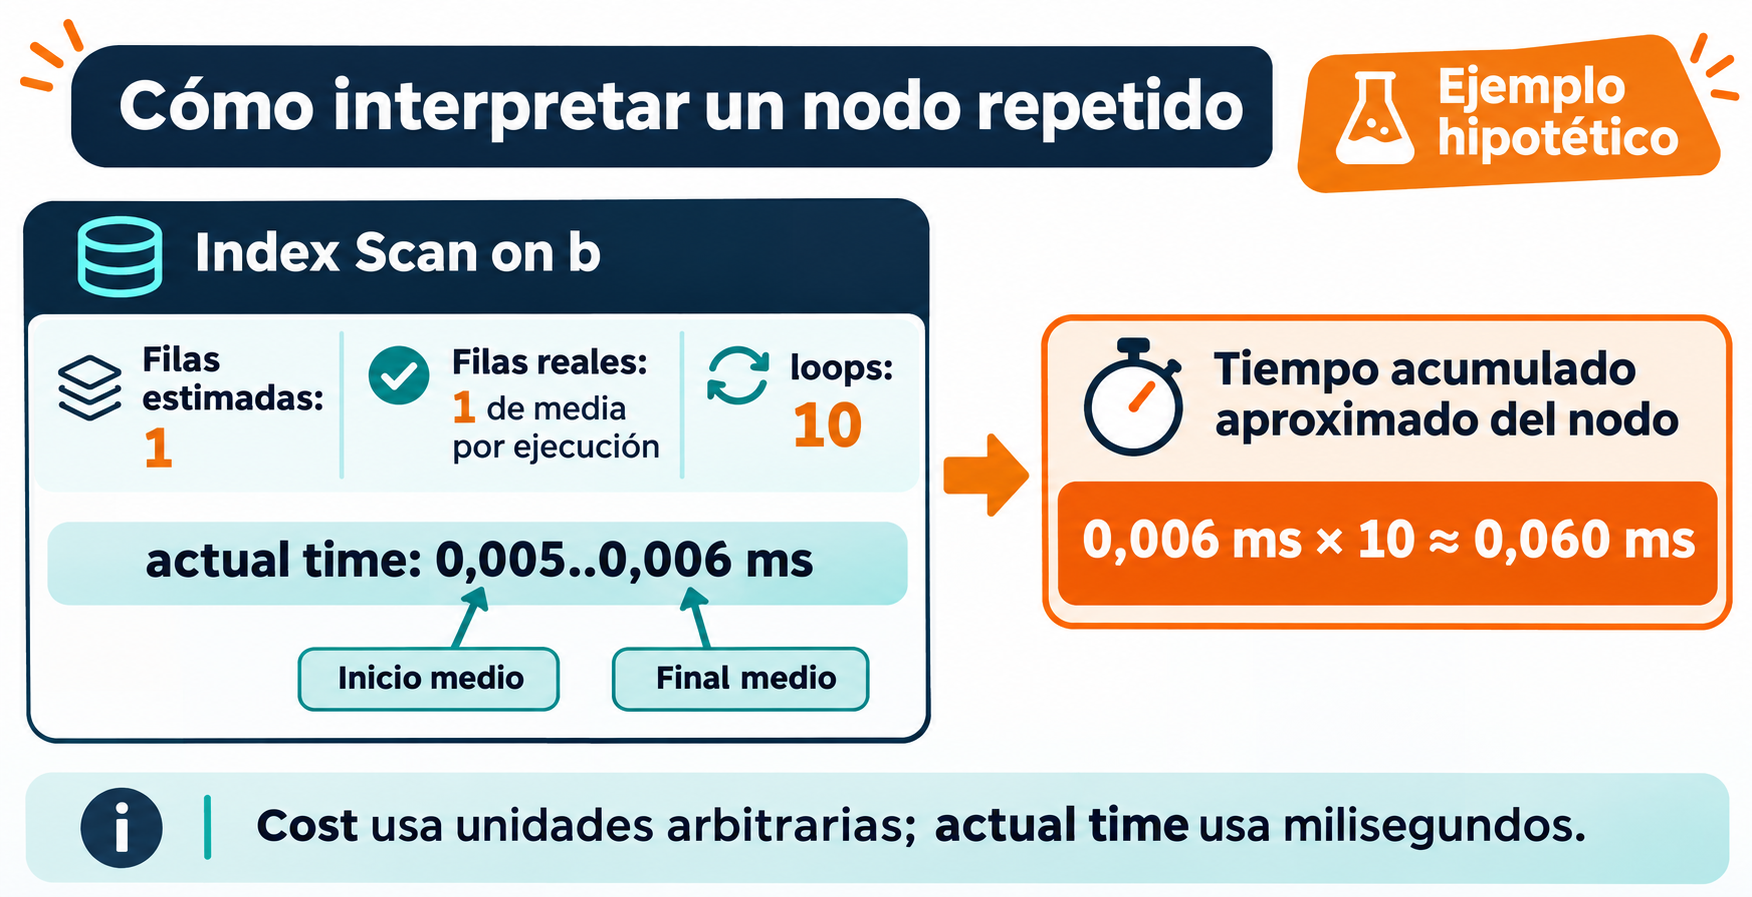
- Segundo hijo: Index Scan on b; cost=0.00..1.00, filas estimadas=1; actual time=0.005..0.006, filas reales=1, loops=10.
Los dos escaneos son hijos de Nested Loop. En el escaneo de índice, la estimación es una fila y la cifra real es una fila de media por ejecución. Los valores 0,005 y 0,006 son los tiempos medios de inicio y final, en milisegundos; loops=10 indica diez ejecuciones.
La sección 14.1.2 de Using EXPLAIN precisa que, cuando hay varias ejecuciones, «actual time and rows values shown are averages per-execution»: los tiempos y las filas reales mostrados son promedios por ejecución. También indica «Multiply by the loops value» para obtener el tiempo total del nodo. En el ejemplo hipotético, 10 × 0,006 aproxima 0,060 ms acumulados para el tiempo final de ese nodo, sujeto al redondeo.
3. Compara las filas estimadas y reales
En cada nodo, compara las filas estimadas con las reales. Una diferencia grande es una pista para investigar, pero no basta para diagnosticar un error de estimación. Un padre puede dejar de leer antes de que el hijo termine.
En el ejemplo de LIMIT de la sección 14.1.3, un Index Scan estimado en diez filas devuelve dos. La guía explica que «the Limit node stopped requesting rows after it got two»: el nodo Limit dejó de pedir filas tras recibir dos. La estimación del escaneo suponía que este se completaría.
Si la diferencia merece investigación, revisar las estadísticas es un paso razonable. La referencia de ANALYZE indica en Description que «the query planner uses these statistics». En Notes explica que, para tablas grandes, se usa una muestra aleatoria y las estadísticas son aproximadas. Una discrepancia no prueba que estén desactualizadas ni garantiza que actualizarlas mejore el plan.
4. Distingue coste, tiempo y repeticiones
Cost presenta estimaciones de inicio y de ejecución completa en unidades arbitrarias. Actual time muestra tiempos reales en milisegundos. Como explica la guía de EXPLAIN, no son cifras que deban compararse como si compartieran unidad.
Revisa loops antes de interpretar un nodo repetido. Multiplicar las filas reales medias por las ejecuciones aproxima el total de filas emitidas por ese nodo; multiplicar el tiempo final medio por las ejecuciones aproxima su tiempo acumulado. Como cautela práctica, evita sumar sin más los tiempos de distintos nodos para obtener la duración de la consulta.
5. Usa BUFFERS para contextualizar el trabajo
La referencia de EXPLAIN, en el parámetro BUFFERS, define un hit como una lectura evitada —«a read was avoided»— porque el bloque ya estaba en caché. También indica que los contadores de bloques de un nodo superior incluyen los de sus hijos. La sección 14.1.2 de Using EXPLAIN describe los recuentos como «non-distinct buffers»: no necesariamente corresponden a bloques distintos. Por ello, sumar sin más los valores de padres e hijos puede duplicar actividad.
6. Interpreta el tiempo observado en contexto
El tiempo de EXPLAIN ANALYZE no equivale necesariamente a la latencia que percibe un cliente. La referencia de EXPLAIN señala en Notes que la medición añade «profiling overhead»; además, la sección 14.1.3 de Using EXPLAIN explica que no se entregan las filas al cliente y se excluye la transmisión por red.
En PostgreSQL 18, según el parámetro SERIALIZE de la referencia, SERIALIZE TEXT o SERIALIZE BINARY realiza la conversión de salida correspondiente y mide su tiempo «unless TIMING OFF is specified», es decir, salvo que se indique TIMING OFF. EXPLAIN no envía los datos resultantes al cliente, por lo que esta opción no mide el coste de transmisión por red.
La misma referencia indica que habilitar la serialización requiere ANALYZE. El comportamiento predeterminado es «SERIALIZE NONE», que no realiza la conversión; especificar SERIALIZE sin argumento supone TEXT.
Una secuencia práctica de lectura
- Identifica los escaneos inferiores y sigue las filas hacia el nodo superior.
- Busca diferencias entre filas estimadas y reales, teniendo en cuenta si un padre pudo detener la lectura antes.
- Revisa loops antes de interpretar el tiempo y las filas de un nodo repetido.
- Examina los buffers sin sumar indiscriminadamente los contadores de padres e hijos.
- Si las estimaciones divergen, investiga las estadísticas y el contexto de la consulta antes de decidir un cambio.
Sin una consulta y un plan reales, no es posible identificar aquí un cuello de botella ni recomendar un índice específico. La investigación suministrada tampoco comprueba la disponibilidad o el comportamiento de estas opciones en versiones distintas de PostgreSQL 18.
Comentarios
Publicar un comentario