Cómo leer EXPLAIN en PostgreSQL antes de crear otro índice
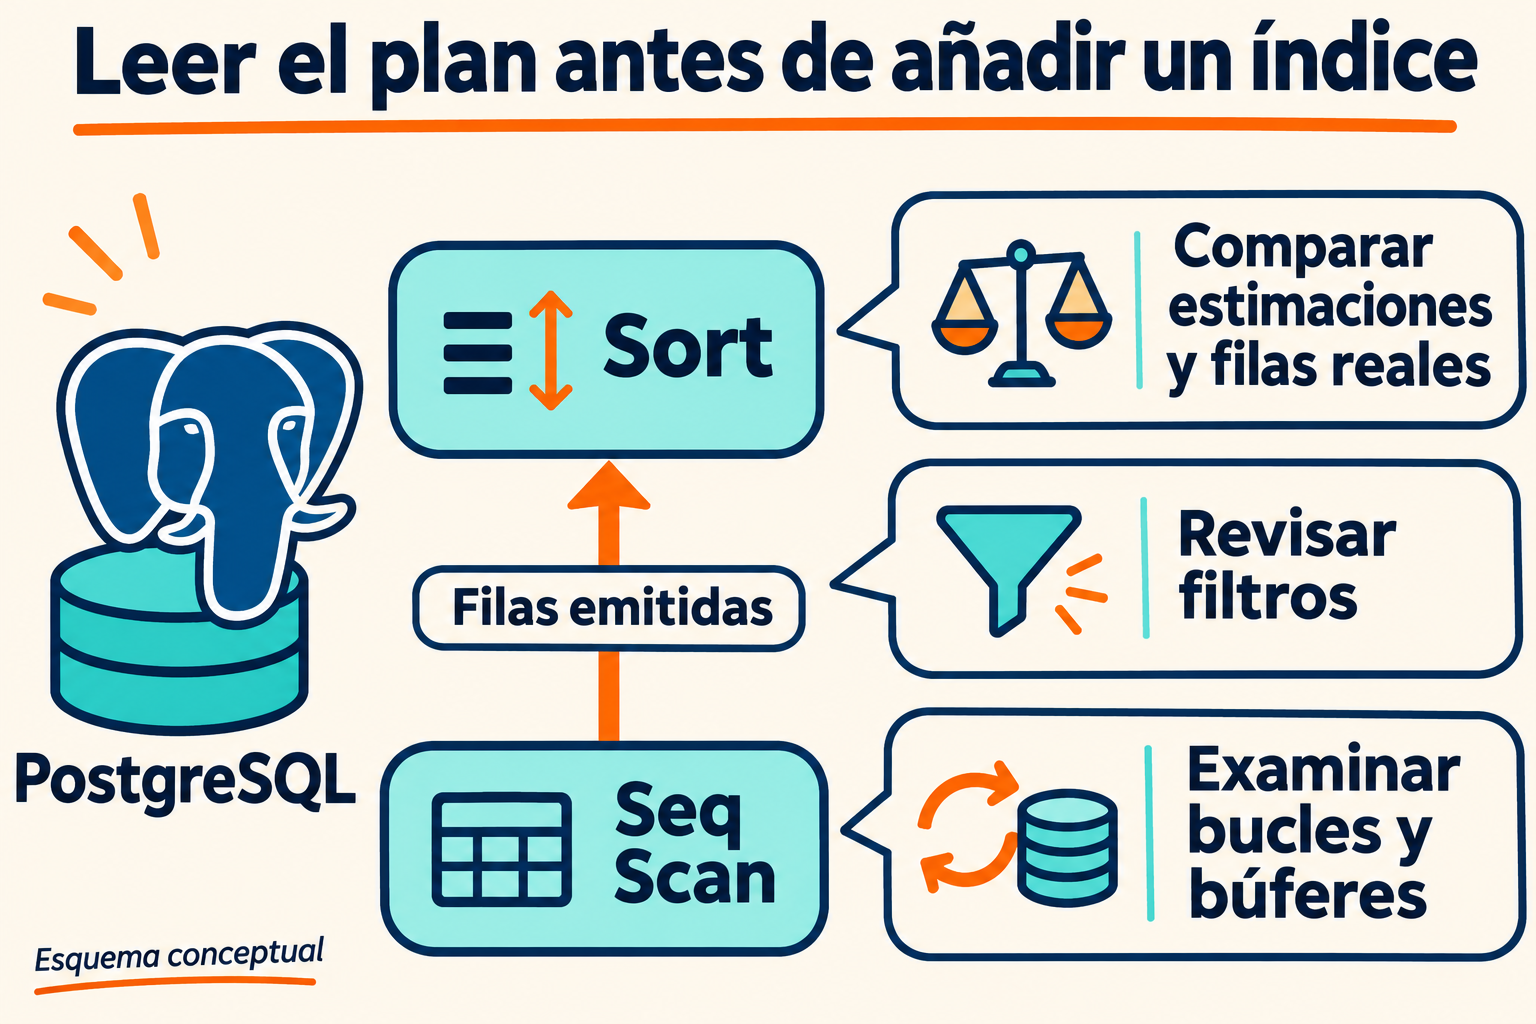
Antes de añadir un índice, examina dónde trabaja la consulta, cuántas filas espera emitir PostgreSQL en cada nodo y cuántas emite realmente. Un Seq Scan por sí solo no demuestra que falte un índice: la documentación señala que un recorrido secuencial puede ser razonable para una tabla pequeña.
1. Obtén un plan representativo
Para una consulta SELECT representativa, usa EXPLAIN (ANALYZE, BUFFERS) SELECT ...;. EXPLAIN ANALYZE ejecuta la sentencia y añade estadísticas reales a las estimaciones; BUFFERS informa sobre bloques encontrados en caché, leídos, ensuciados y escritos.
La instrumentación añade sobrecarga y los posibles efectos laterales de la sentencia ocurren como de costumbre. Si solo necesitas las estimaciones sin ejecutar la consulta, usa EXPLAIN sin ANALYZE.
2. Lee el plan como un árbol
Empieza por los nodos inferiores y sigue las filas hacia los superiores. En cada nodo, rows estima las filas que emitirá; actual rows muestra las filas emitidas realmente, en promedio por ejecución. Ninguno de esos valores equivale necesariamente a todas las filas examinadas. Rows Removed by Filter muestra por separado los rechazos de un filtro.
La sección 14.1.1 de Using EXPLAIN precisa que rows es «the number emitted by the node», no el número procesado o escaneado. La sección 14.1.2 añade que los valores reales de tiempo y filas son «averages per-execution» cuando hay varias ejecuciones. loops indica cuántas veces se ejecutó el nodo.
Un ejemplo para practicar
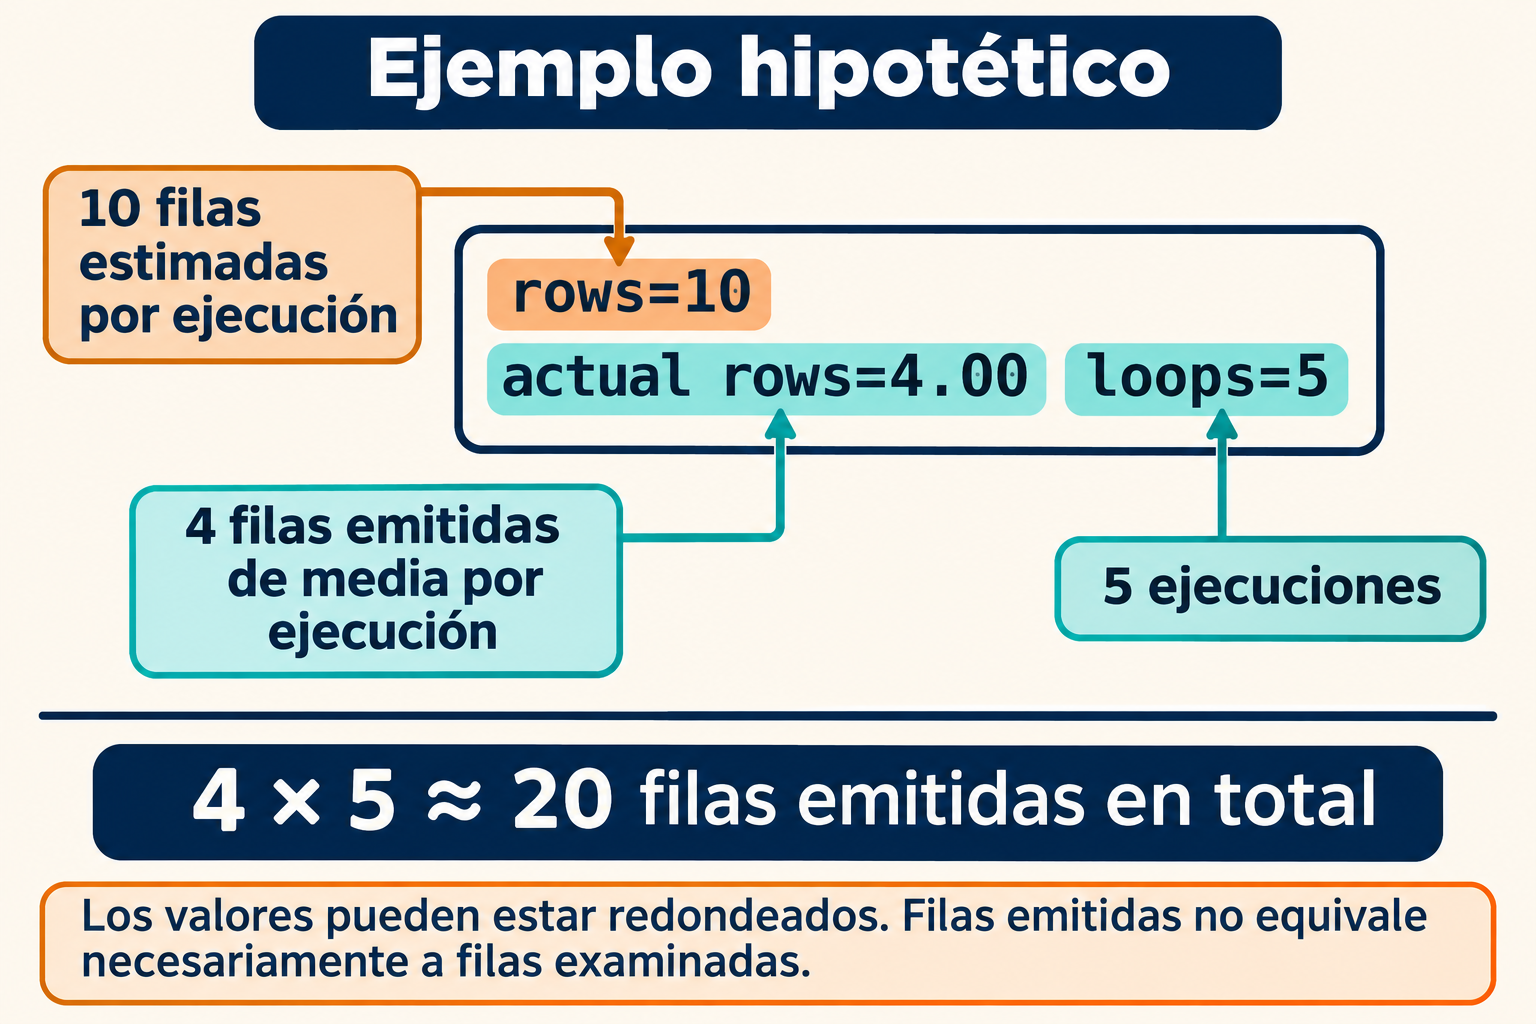
Supón que un nodo de un plan hipotético muestra rows=10 y actual rows=4.00 loops=5. El planificador estimó 10 filas emitidas por ejecución; el nodo emitió 4 de media en cada una de sus 5 ejecuciones, unas 20 en total. Los valores mostrados pueden estar redondeados. Este ejemplo ilustra la lectura y no es una medición real.
3. Investiga las diferencias de filas
Una gran diferencia entre filas estimadas y reales merece atención antes de atribuir un problema a la falta de un índice. Comprueba si las estadísticas están actualizadas y, cuando corresponda, ejecuta ANALYZE sobre la tabla. La guía sobre evaluación del uso de índices recomienda disponer de estadísticas y experimentar con datos reales.
Interpreta la comparación con cautela si un nodo se detuvo antes de terminar, por ejemplo por un LIMIT. Las estimaciones suponen que el nodo se ejecuta hasta completarse, mientras que las filas observadas pueden reflejar una parada anticipada. La sección 14.1 de Using EXPLAIN explica ambos casos.
4. Distingue el acceso del filtrado posterior
En un acceso por índice, Index Cond identifica las condiciones aplicadas al acceso. Filter y Rows Removed by Filter ayudan a identificar el filtrado posterior y sus rechazos. La documentación distingue estos últimos de Rows Removed by Index Recheck, que puede aparecer en una comprobación posterior de índice con pérdida; consulta los ejemplos de la sección 14.1.2 de Using EXPLAIN.
Un escaneo que descarta muchas filas para devolver pocas es una señal para investigar, no una prueba suficiente de que convenga otro índice. Examina también el resto del plan y la carga.
5. Busca el trabajo acumulado
- Bucles: un nodo aparentemente barato puede acumular trabajo si se ejecuta muchas veces. Lee sus promedios junto con loops.
- Búferes: los contadores de un nodo incluyen los de sus hijos y pueden contar un mismo búfer más de una vez. Sumarlos sin más puede duplicar trabajo.
- Ordenaciones: Sort Method identifica el método y el espacio de memoria o disco utilizado. Una ordenación puede merecer investigación aunque la atención inicial estuviera en el acceso a la tabla.
La sección 14.1.2 de Using EXPLAIN describe los búferes como «non-distinct» e indica que los valores comprenden el nodo y todos sus hijos; también explica la información de las ordenaciones.
6. Prueba una propuesta antes de adoptarla
Si el plan apunta a que un índice podría reducir trabajo, revisa primero los índices existentes y plantea una prueba con datos y parámetros representativos. En un B-tree multicolumna, las igualdades en las columnas iniciales y una desigualdad en la primera columna sin igualdad delimitan la parte del índice que se recorre. La sección 11.3 también explica que PostgreSQL 18 puede emplear skip scan mediante búsquedas repetidas para reducir aún más la lectura; las condiciones sobre columnas posteriores también pueden ser útiles. Evalúa el orden de las columnas para la consulta concreta.
Compara planes, tiempos y búferes antes y después, y considera el efecto sobre las escrituras. Los índices requieren mantenimiento cuando se modifican los datos; que uno pueda usarse no demuestra por sí solo que compense para toda la carga.
Sin la consulta, su plan, la versión del servidor, los índices existentes y datos de la carga no es posible identificar aquí un cuello de botella ni recomendar un índice específico. Las referencias corresponden a PostgreSQL 18; no se ha comprobado la aplicabilidad exacta de estas capacidades y su presentación a otras versiones.
Comentarios
Publicar un comentario