Cómo leer un plan de ejecución de PostgreSQL para investigar una consulta lenta
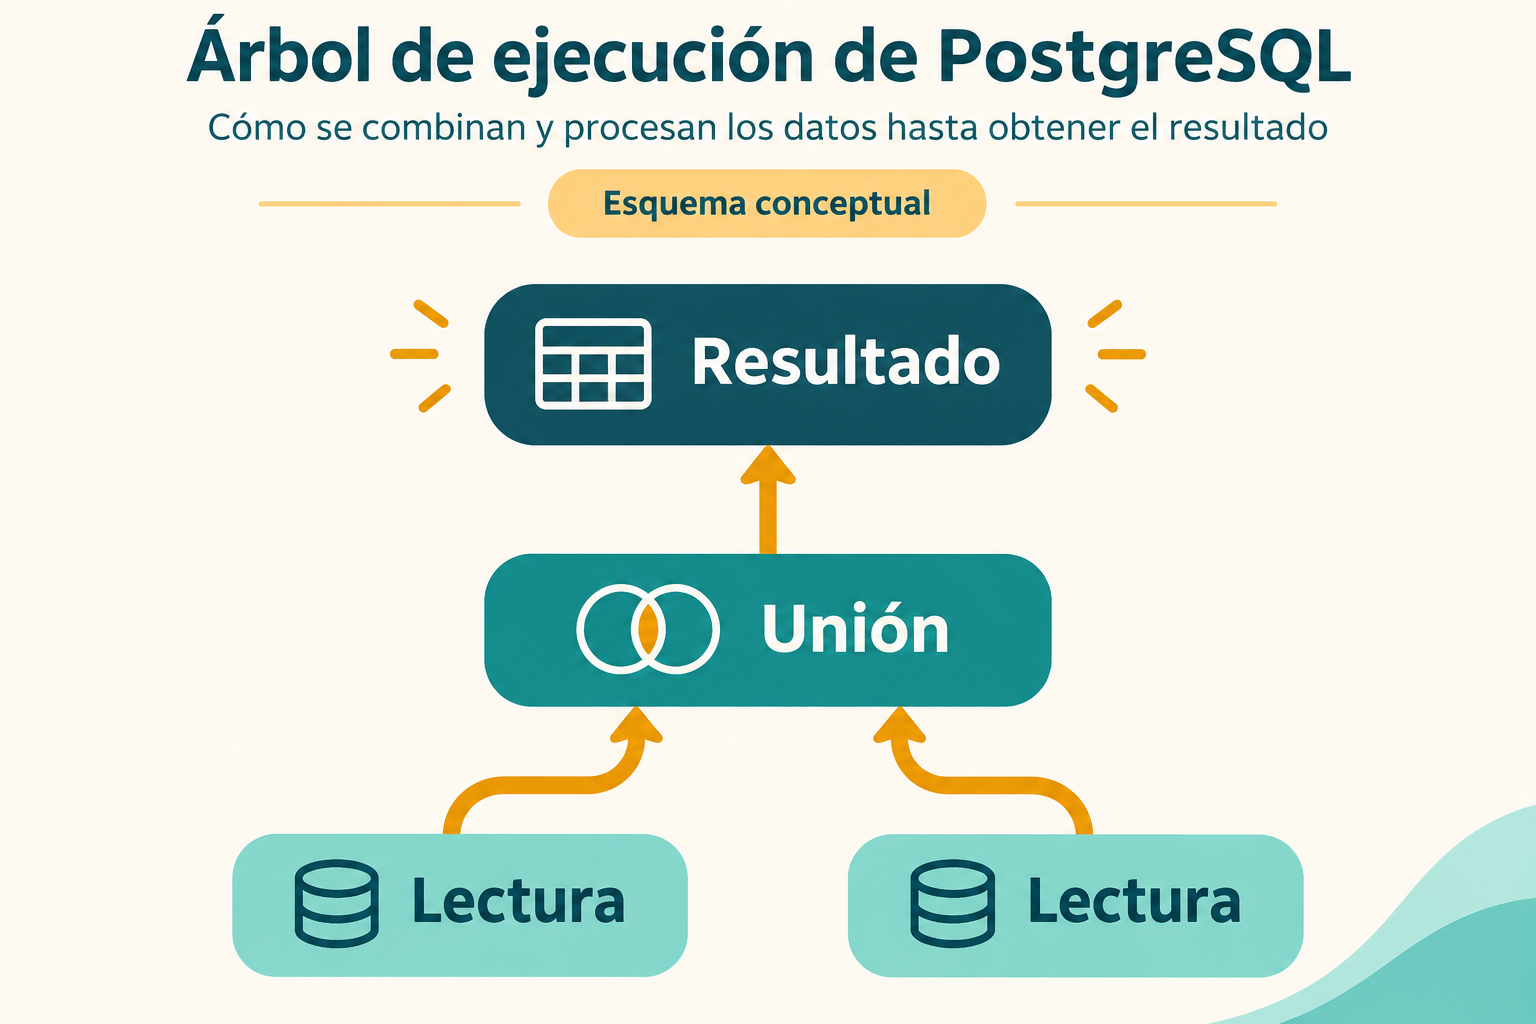
Un plan de ejecución muestra las operaciones elegidas para resolver una consulta. Con mediciones reales, ayuda a localizar trabajo que merece investigación y a formular hipótesis. Esta guía utiliza la documentación de PostgreSQL 18; la interpretación depende de la consulta, el plan y la versión.
1. Obtén un plan con mediciones
Si ejecutar la sentencia es apropiado, comienza con EXPLAIN (ANALYZE, BUFFERS) SELECT ...;, sustituyendo el ejemplo por la consulta que quieres investigar. En PostgreSQL 18, escribir BUFFERS hace explícita la información solicitada: el apartado BUFFERS de EXPLAIN indica que «Buffers information is automatically included when ANALYZE is used».
ANALYZE ejecuta la sentencia y sus efectos secundarios ocurren normalmente. Incluso un SELECT puede cambiar el estado de la base de datos: la documentación de funciones de secuencia muestra SELECT setval('myseq', 42), que cambia el estado de una secuencia. Además, las notas de EXPLAIN advierten que la instrumentación añade sobrecarga.
2. Recorre el árbol y lee las mediciones
Como pauta práctica, recorre el árbol desde las lecturas inferiores hacia la raíz para seguir cómo las operaciones superiores reciben y procesan filas. Según Using EXPLAIN, sección 14.1.1, la estimación rows corresponde a las filas emitidas por el nodo, no necesariamente a todas las que examina. Los costes se expresan en unidades arbitrarias, no en milisegundos.
Con ANALYZE, actual time muestra tiempos reales en milisegundos. Cuando un nodo se ejecuta varias veces, los tiempos y las filas reales mostrados son «averages per-execution», es decir, promedios por ejecución; loops indica el número de ejecuciones. La sección 14.1.2 de Using EXPLAIN recomienda multiplicar el tiempo por loops para obtener el tiempo empleado en el nodo. Los cálculos con valores impresos están sujetos a redondeo.
3. Compara estimaciones con resultados
Considera este fragmento hipotético de un plan:
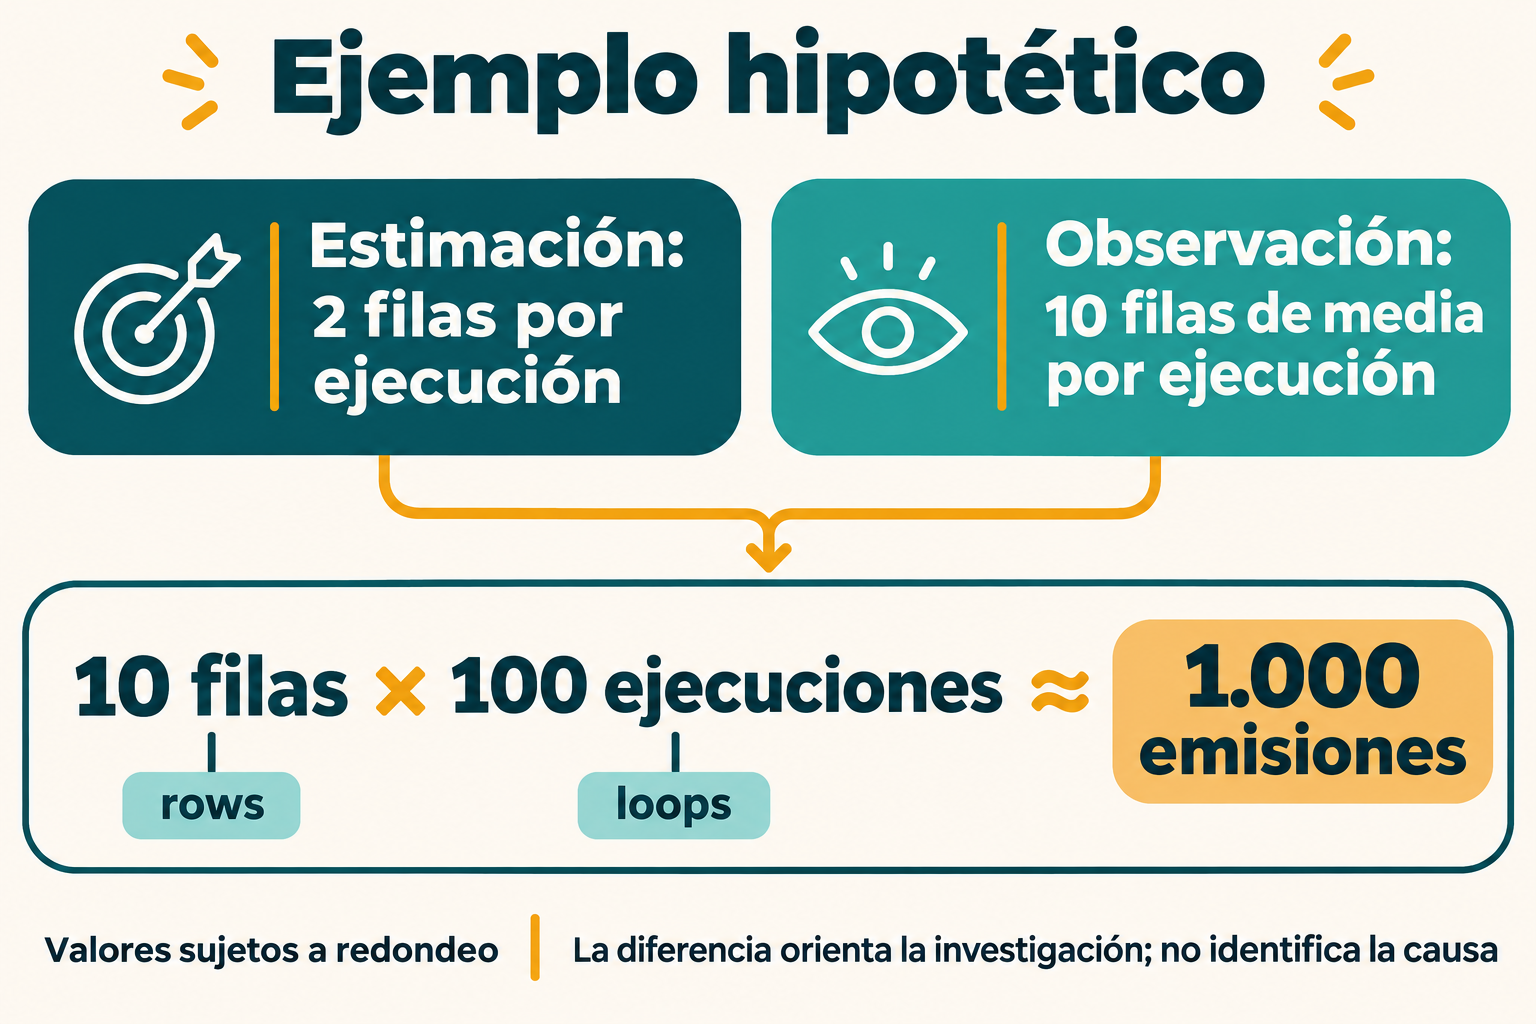
Index Scan (cost=0.29..8.00 rows=2 width=16) (actual time=0.020..0.050 rows=10.00 loops=100)
La estimación es de dos filas emitidas y se observaron diez de media por ejecución. En cien ejecuciones son aproximadamente 1.000 emisiones, sujetas al redondeo del valor mostrado. La diferencia invita a investigar; por sí sola no identifica la causa ni demuestra una solución.
Antes de concluir que una estimación es errónea, comprueba si el nodo se detuvo anticipadamente. En un ejemplo de Using EXPLAIN, sección 14.1.3, LIMIT deja de solicitar filas al Index Scan después de recibir dos, aunque las estimaciones de este suponían una ejecución completa.
4. Examina búferes, filtros y ordenaciones
Estas señales ayudan a orientar la investigación, pero ninguna constituye un diagnóstico automático:
- Búferes: revisa los contadores de los nodos relevantes. El apartado BUFFERS de EXPLAIN precisa que los bloques mostrados para un nodo superior incluyen los usados por sus hijos. Por eso, sumar contadores entre niveles puede contabilizar parte del trabajo más de una vez.
- Filas descartadas: si un filtro elimina muchas filas, investiga el predicado y, según el contexto, los índices disponibles.
- Ordenaciones: revisa el método y el espacio usados; pueden orientar la investigación de trabajo temporal.
- Seq Scan: una lectura secuencial por sí sola no demuestra un problema; valora cuántas filas necesita la consulta y el contexto de la tabla.
5. Comprueba una hipótesis y vuelve a medir
Si las estimaciones y las filas reales difieren mucho, revisa la vigencia de las estadísticas. ANALYZE recopila estadísticas sobre el contenido de las tablas y el planificador las utiliza para determinar planes de ejecución. Actualizarlas es una hipótesis que conviene comprobar, no una garantía de mejora. Compara los planes y tiempos de nuevo en condiciones semejantes.
La medición tampoco representa toda la latencia observada por el cliente. Según el apartado SERIALIZE de EXPLAIN, SERIALIZE NONE no convierte los resultados. Con SERIALIZE TEXT o SERIALIZE BINARY se realiza la conversión y se mide su tiempo, salvo con TIMING OFF; la documentación precisa que «Serialization may only be enabled when ANALYZE is also enabled». EXPLAIN no envía los resultados al cliente, por lo que no mide su transmisión por red.
Para identificar un cuello de botella concreto hacen falta la consulta, su plan y contexto sobre la versión, las tablas y los índices.
Comentarios
Publicar un comentario