Índices en PostgreSQL: cómo comprobar si una consulta realmente los necesita
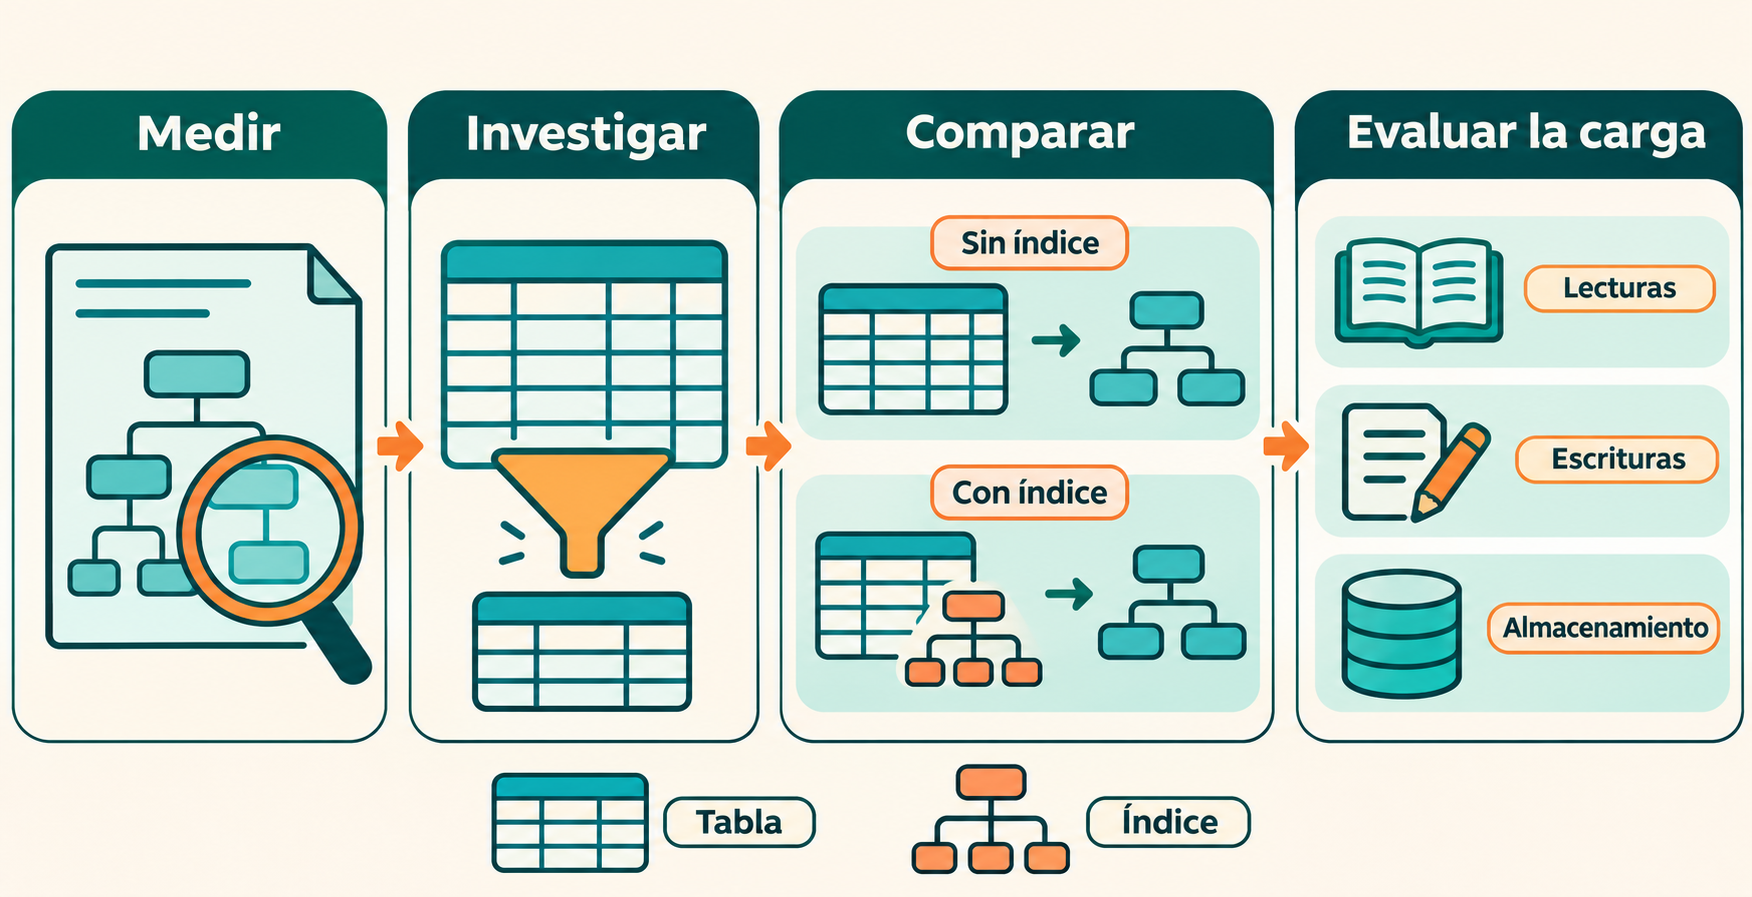
Para evaluar un índice, mide su efecto sobre la consulta y considera también el coste para el resto de la carga. Un Seq Scan no demuestra por sí solo que falte un índice: la documentación de PostgreSQL 18 presenta el caso de una tabla de 100 filas que probablemente caben en una página, donde una lectura secuencial puede ser apropiada. Es un ejemplo de escala, no una regla para cualquier consulta.
Sin una consulta concreta, su plan, los datos y mediciones de la carga, no se puede determinar si un índice específico mejorará el rendimiento o si su beneficio compensará su coste. Este procedimiento ayuda a reunir esa evidencia.
1. Obtén una línea de base
Para una consulta SELECT, ejecuta EXPLAIN (ANALYZE, BUFFERS) seguido de la consulta y guarda el resultado. Como criterio de prueba, utiliza datos, parámetros y volúmenes representativos. Examina los nodos de acceso, las filas estimadas y reales, los tiempos y los buffers.
EXPLAIN ANALYZE ejecuta la sentencia. La sección 14.1.2 de Using EXPLAIN lo expresa así: «EXPLAIN actually executes the query». La sección 14.1.3 añade límites para interpretar el tiempo: no se transmiten filas al cliente, por lo que se excluye el tiempo de red; la conversión de salida también se excluye salvo que se solicite SERIALIZE, y la medición puede añadir una sobrecarga significativa.
2. Busca trabajo que pueda evitarse
Revisa dónde se concentra el trabajo y cuántas filas se descartan. Por ejemplo, un Seq Scan con muchas filas descartadas puede justificar investigar un índice compatible con el filtro; el número de descartes no demuestra por sí solo que el índice vaya a mejorar la consulta.
Compara también las filas estimadas con las reales. Según Using EXPLAIN, sección 14.1.2, cuando un nodo se ejecuta varias veces, los tiempos y las filas reales son promedios por ejecución. La sección 14.1.1 explica que las estimaciones de filas y coste total suponen que el nodo termina. En el ejemplo con LIMIT de la sección 14.1.3, el nodo hijo devuelve solo dos filas porque se detiene antes; la documentación aclara que esa diferencia no es un error de estimación.
Comprueba las estadísticas antes de atribuir una diferencia a la falta de un índice. ANALYZE recopila estadísticas de las tablas que ayudan al planificador. Para examinar el uso de índices, la sección 11.12 recomienda ejecutar ANALYZE primero; esto no implica que haya que ejecutarlo manualmente antes de cada consulta.
3. Compara con y sin el índice candidato
En un entorno de pruebas representativo, mide la misma consulta sin el índice candidato y después con él. Repite la comparación con valores habituales y condiciones de caché comparables; examina el tiempo, los buffers y el plan completo. Estas repeticiones son una recomendación práctica para hacer más útil la comparación.
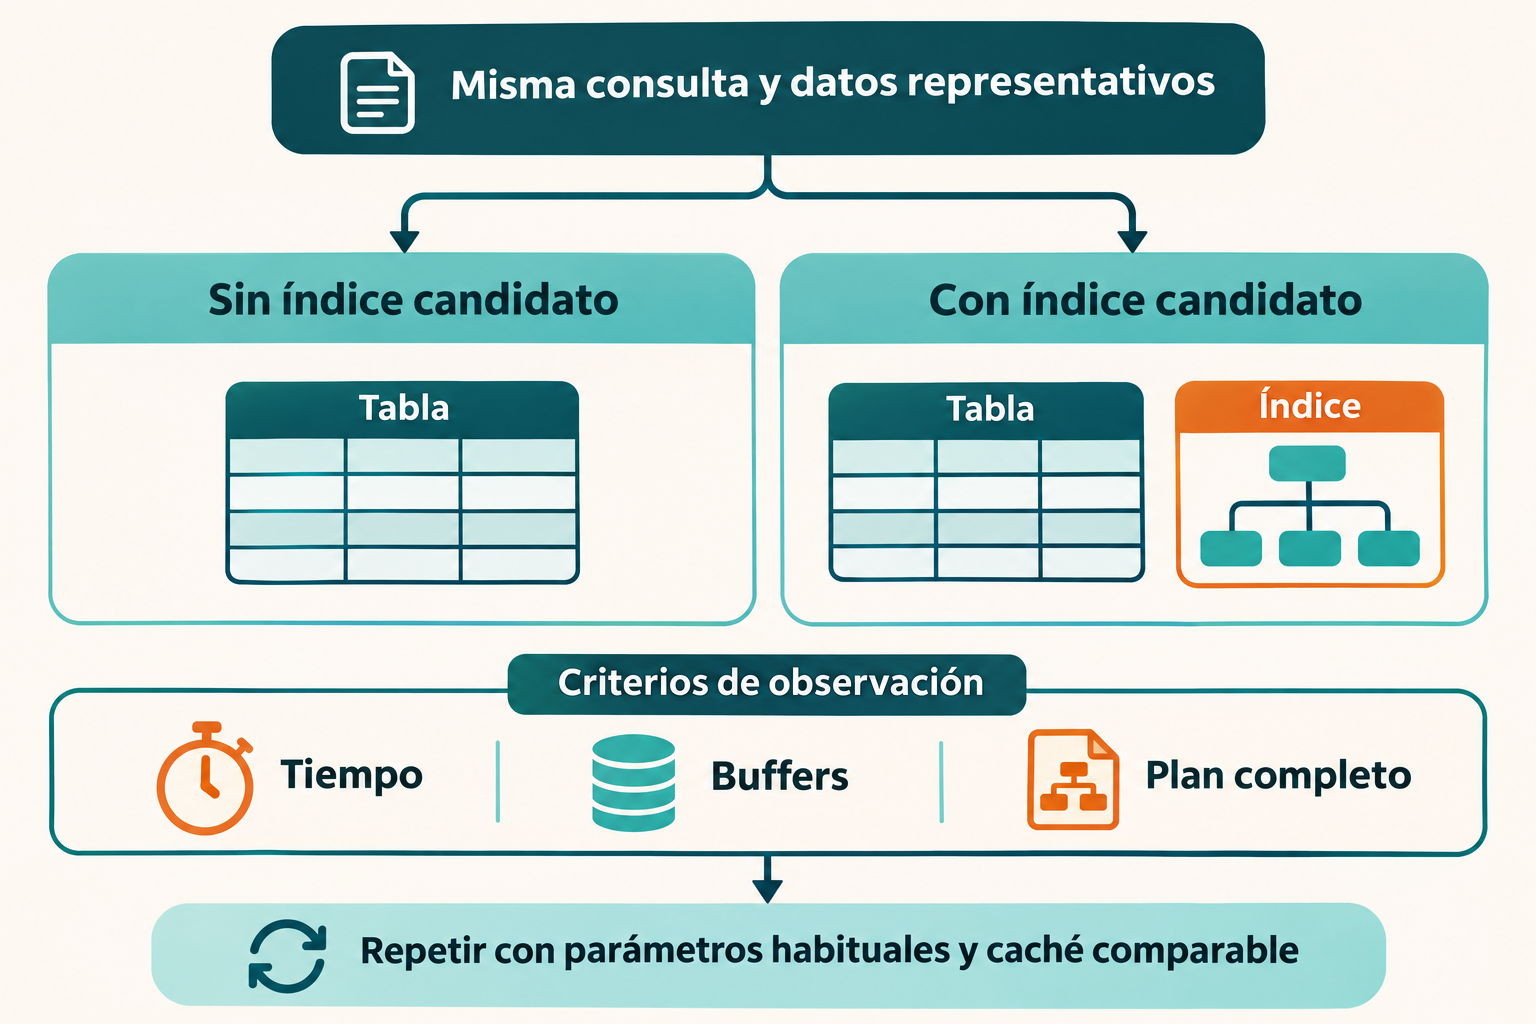
La documentación recomienda experimentar con datos reales y medir la consulta con y sin índices. Que un plan utilice un índice no garantiza, por sí solo, una mejora: las mediciones son la evidencia relevante para la consulta y las condiciones probadas.
Si el planificador no elige el índice
Revisa si la condición de la consulta coincide con el índice y si las estadísticas son adecuadas. Un plan alternativo puede ayudar a investigar la decisión, pero conviene medirlo antes de concluir que es mejor.
4. Evalúa la carga de trabajo completa
Una mejora de lectura debe valorarse junto con el efecto del índice en el conjunto de la carga. La introducción a los índices explica que mantenerlos sincronizados añade sobrecarga a las modificaciones de datos y puede impedir actualizaciones HOT.
Como recomendación práctica, compara en un entorno representativo la carga con y sin el índice candidato. Mantén comparables la mezcla de operaciones y la concurrencia, y mide:
- La latencia y el rendimiento de INSERT, UPDATE y DELETE.
- La latencia y el rendimiento de las lecturas relevantes, incluida la consulta que motivó la prueba.
- La E/S, el WAL y el espacio ocupado.
Para cuantificar el espacio, las funciones de administración de PostgreSQL incluyen pg_relation_size para el archivo principal de una relación, incluido un índice, y pg_indexes_size para el espacio de todos los índices de una tabla. El resultado de la comparación depende del sistema y de la carga probados.
Interpreta los contadores de uso con cuidado
Para investigar un índice existente, observa las estadísticas acumuladas durante un período representativo. La tabla 27.30 define idx_scan como el número de exploraciones iniciadas en el índice. La nota posterior precisa: «Each index search increments pg_stat_all_indexes.idx_scan». Como una ejecución de un nodo puede realizar varias búsquedas, el contador no equivale necesariamente al número de ejecuciones de consultas o de nodos.
La misma guía, en la sección 27.2.1, indica que las estadísticas pueden conservarse tras una parada limpia y se reinician tras una parada no limpia; la recogida de accesos a tablas e índices depende de track_counts. La sección 27.2.2 explica que la publicación puede demorarse y que, con la configuración predeterminada, los valores consultados permanecen en caché hasta terminar la transacción.
Un contador bajo es una señal para investigar, no una prueba suficiente de que pueda eliminarse el índice. Considera también las consultas poco frecuentes y las restricciones que pueda respaldar.
Las fuentes enlazadas corresponden a PostgreSQL 18. Comprueba los detalles aplicables a la versión que utilizas.
Comentarios
Publicar un comentario