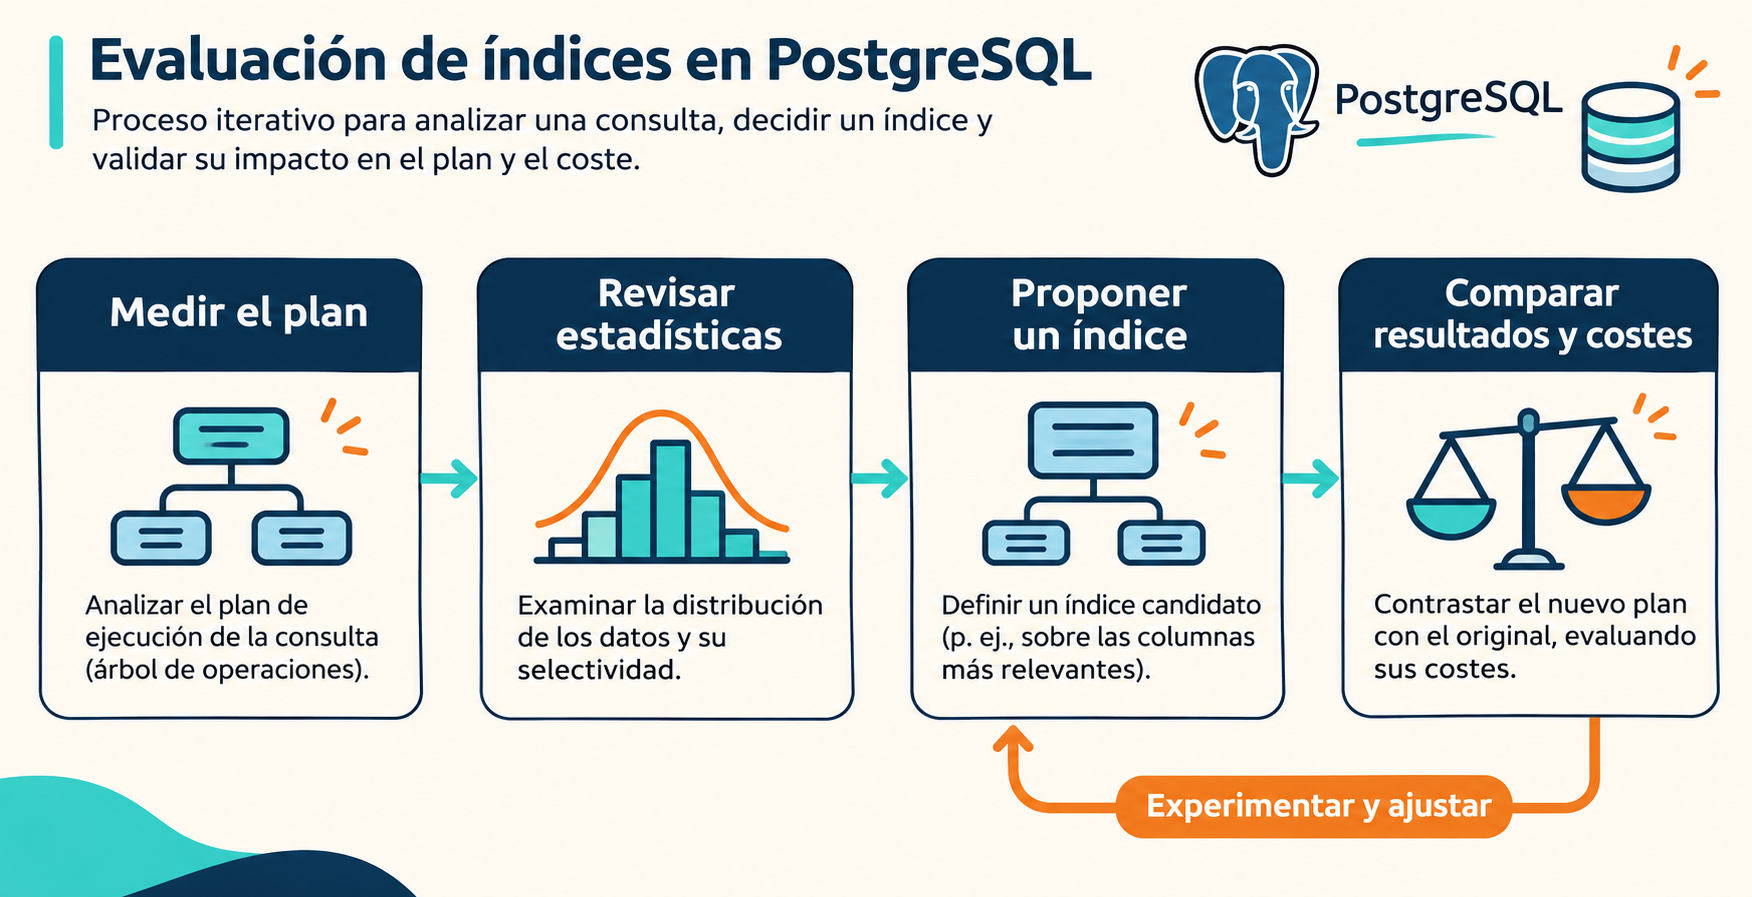
Índices en PostgreSQL: cómo decidir cuál crear a partir de una consulta lenta
Una consulta lenta no indica por sí sola qué índice necesita. Empieza por medir su plan, identifica los filtros y el orden que podrían beneficiarse de un índice y compara el resultado con datos representativos. Esta guía utiliza la investigación suministrada sobre PostgreSQL 18.
1. Obtén un plan real
Como línea de base, ejecuta EXPLAIN (ANALYZE, BUFFERS) seguido de la consulta. Compara las filas estimadas con las reales y observa los bucles y el uso de búferes. Con varios bucles, los tiempos y las filas reales son promedios por ejecución: Using EXPLAIN, sección 14.1.2, lo expresa como «actual time and rows values shown are averages per-execution».
Al interpretar los búferes, evita sumar sin más las cifras de nodos superiores e inferiores. La descripción de BUFFERS en EXPLAIN indica que la información de un nodo incluye la de sus hijos: «includes those used by all its child nodes».
EXPLAIN ANALYZE ejecuta la sentencia y puede producir efectos secundarios. Tenlo especialmente en cuenta con sentencias que modifican datos; consulta el apartado Important de EXPLAIN.
2. Comprueba las estadísticas y el contexto
Comprueba las estadísticas y evalúa la consulta con datos representativos. Entre las recomendaciones de Examining Index Usage, sección 11.12, figuran «Always run ANALYZE first» y «Use real data for experimentation». ANALYZE recoge estadísticas que ayudan a estimar filas y costes.
Un escaneo secuencial puede ser apropiado para una tabla pequeña. Cuando se necesita una proporción grande de sus filas, un escaneo físico seguido de una ordenación explícita también puede ser más rápido; consulta Examining Index Usage e Indexes and ORDER BY. Por tanto, ver un escaneo secuencial en el plan no basta para justificar un índice.
3. Relaciona filtros y orden con un índice candidato
B-tree es un candidato inicial para comparaciones de igualdad y rango; también puede proporcionar resultados ordenados. Estas propiedades se describen en Index Types, sección 11.2.1 y Indexes and ORDER BY.
En un B-tree compuesto, las igualdades en las columnas iniciales y una desigualdad en la primera columna sin igualdad limitan la parte explorada. PostgreSQL 18 también puede elegir skip scan: Multicolumn Indexes, sección 11.3, describe búsquedas repetidas y la generación interna de una restricción de igualdad dinámica: «generating a dynamic equality constraint internally». Su elección depende del coste previsto.
Como punto de partida para una prueba, considera primero las columnas de igualdad y después la columna de rango o de ordenación. Es una inferencia práctica a partir de las propiedades anteriores, no una regla universal: comprueba el orden con el plan y con las demás consultas relevantes.
Ejemplo hipotético: los pedidos más recientes
Supongamos una consulta con esta forma:
SELECT id, created_at FROM pedidos
WHERE cliente_id = 42 AND estado = 'pendiente'
ORDER BY created_at DESC LIMIT 20;
Un candidato para medir sería un índice B-tree sobre cliente_id, estado y created_at DESC, en ese orden. Las dos primeras claves corresponden a las igualdades y la tercera al orden solicitado. Con ORDER BY y LIMIT, un índice compatible puede recuperar directamente las primeras filas, según Indexes and ORDER BY, sección 11.4.
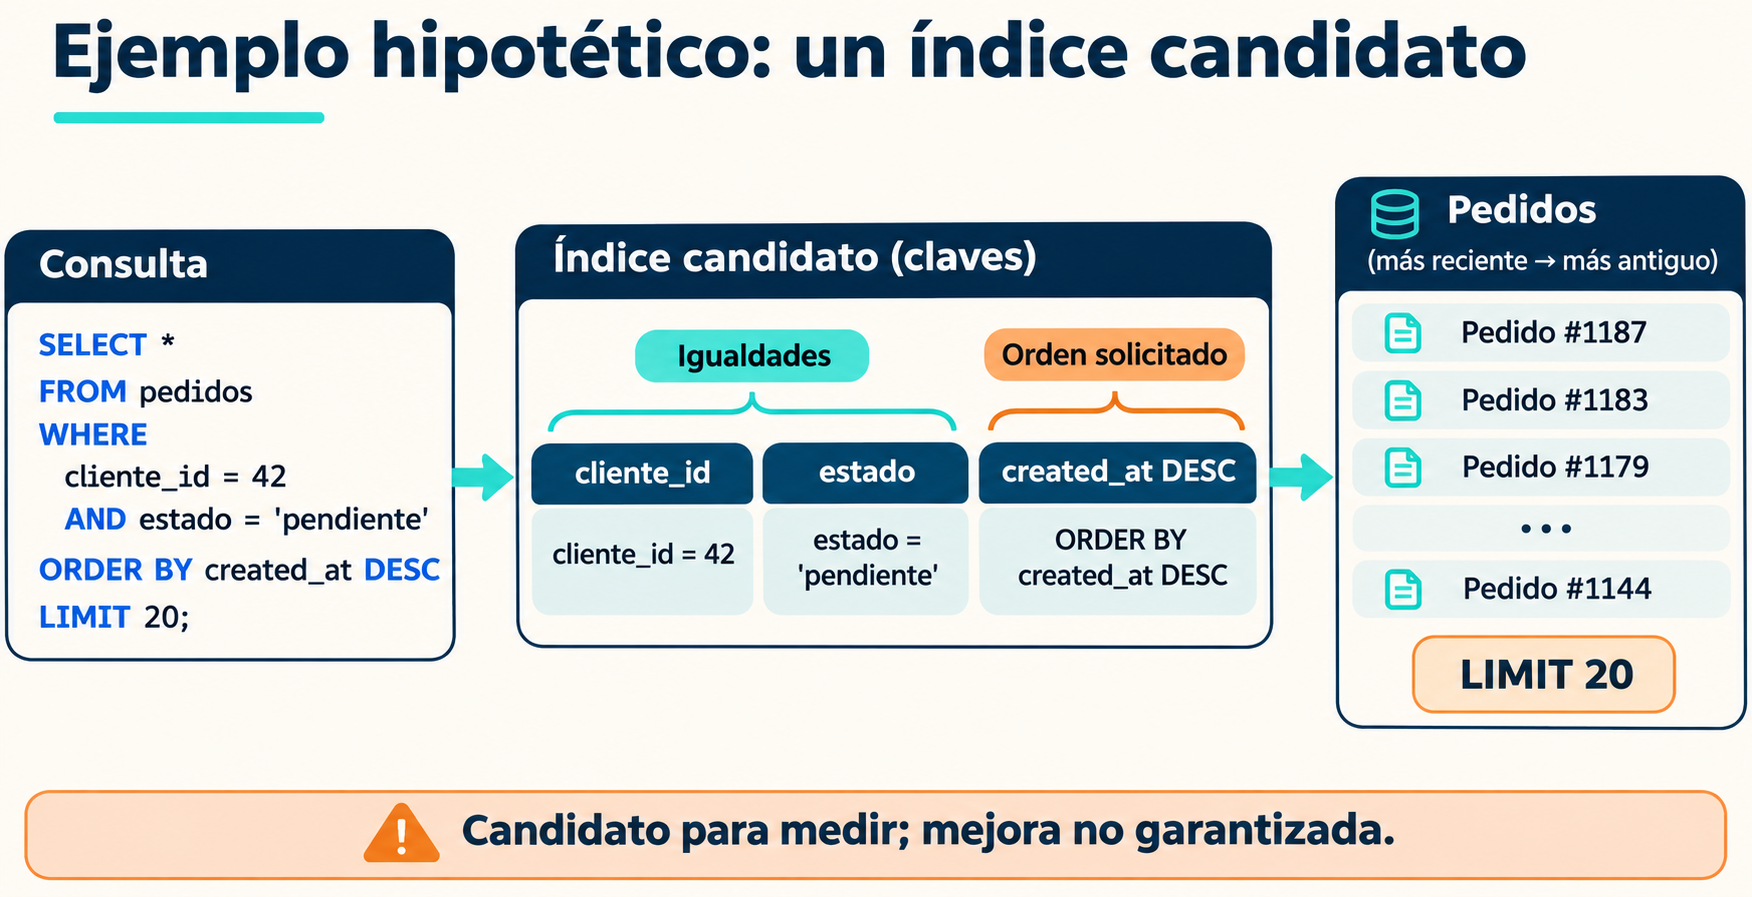
La consulta y el índice son hipotéticos: no se ejecutaron ni se midieron. El orden propuesto es un punto de partida para experimentar, no una garantía de mejora.
4. Considera la operación concreta
- Expresiones: un índice sobre lower(email) puede ayudar a una consulta que use esa expresión. Indexes on Expressions, sección 11.7, muestra un ejemplo equivalente con lower(col1).
- Subconjuntos: para usar un índice parcial, el planificador debe reconocer que la condición de la consulta implica su predicado. La comprobación se realiza durante la planificación; véase Partial Indexes, sección 11.8.
5. Mide el resultado y su coste
Compara los planes y tiempos con y sin el índice usando datos y parámetros representativos, como recomienda Examining Index Usage. Sopesa el resultado frente al espacio y al mantenimiento. Por ejemplo, las expresiones indexadas se calculan en inserciones y actualizaciones no HOT, según Indexes on Expressions.
INCLUDE puede añadir columnas de datos y facilitar un index-only scan, pero no garantiza que se eviten accesos a la tabla. Se necesita un tipo de índice compatible y que el índice contenga los datos necesarios. Además, Index-Only Scans and Covering Indexes, sección 11.9, explica que, si el bit de visibilidad no está marcado, hay que visitar la entrada en la tabla: «If it's not set, the heap entry must be visited». Las columnas adicionales también aumentan el tamaño del índice.
Sin la consulta real, su plan, el esquema, los índices existentes, la versión concreta de PostgreSQL y la distribución de datos, no se puede determinar qué índice mejorará una carga determinada. Los extractos anteriores proceden de la investigación suministrada; no se realizó una verificación externa adicional.
Comentarios
Publicar un comentario