Índices en PostgreSQL: cómo elegir uno para una consulta lenta
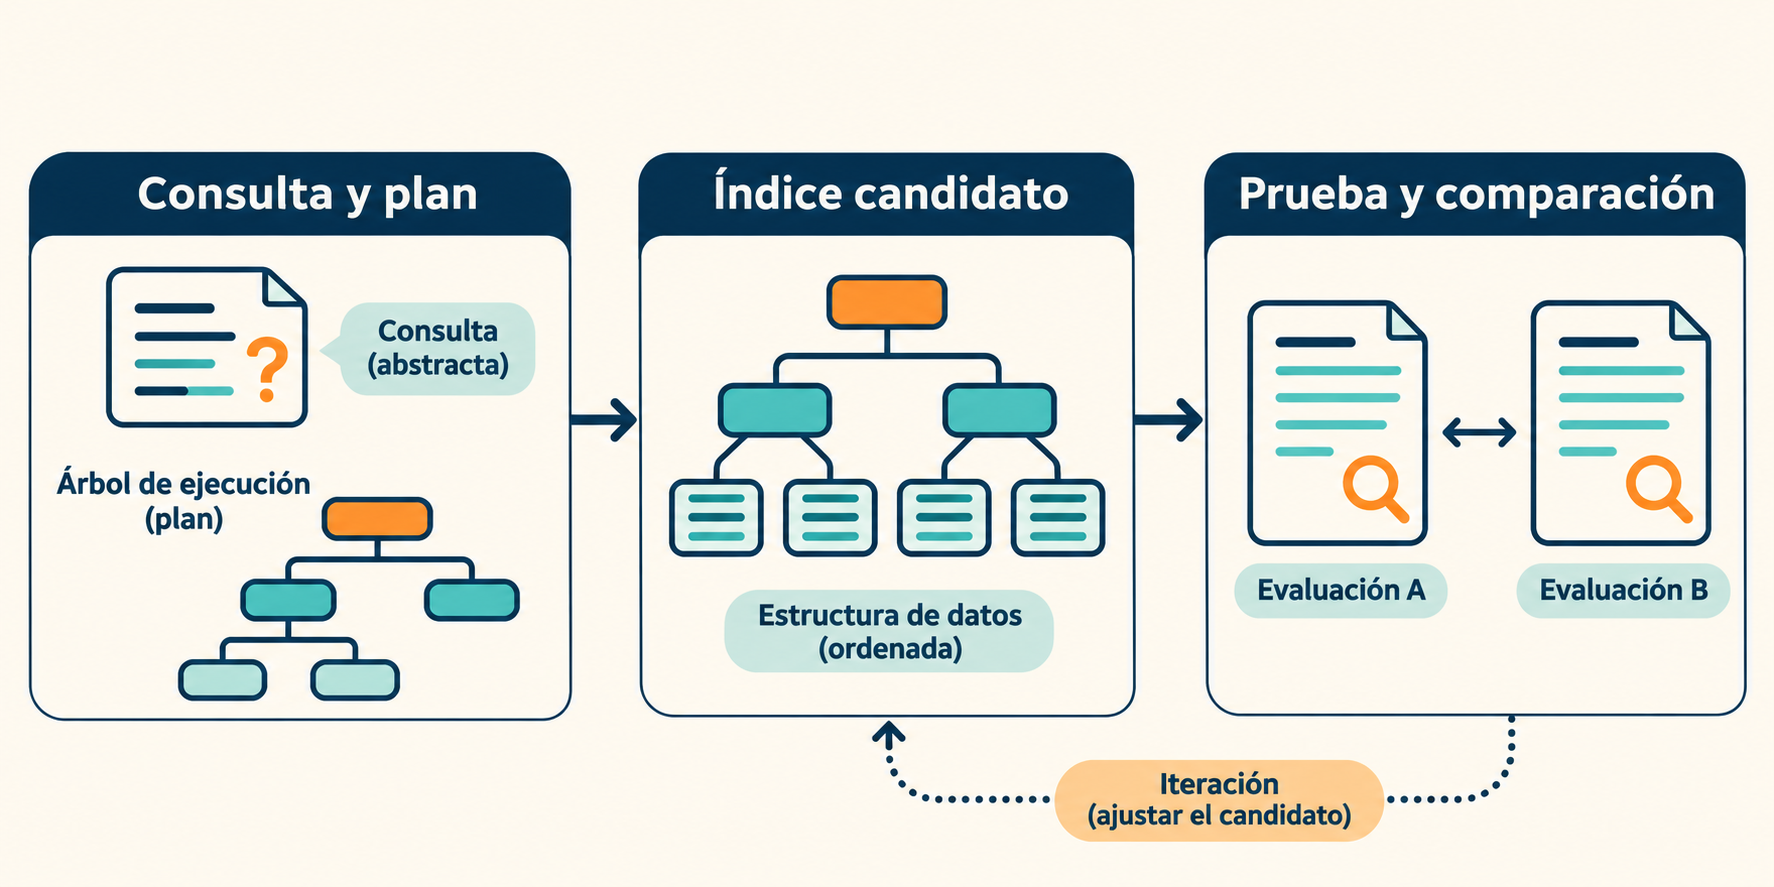
Para elegir un índice, empieza por la consulta y su plan de ejecución. Identifica sus filtros y su ordenación, plantea un candidato y compara los resultados con una carga representativa. La documentación enlazada corresponde a PostgreSQL 18; comprueba los detalles aplicables a tu versión.
1. Observa la consulta y el plan
Como punto de partida, recoge la consulta, el esquema de las tablas, los índices existentes y el plan. Puedes examinarla con EXPLAIN (ANALYZE, BUFFERS) y comparar después el resultado con el de una prueba del índice candidato.
Precaución: la opción ANALYZE de EXPLAIN ejecuta la sentencia, que puede producir sus efectos secundarios habituales. Tenlo en cuenta especialmente si la sentencia modifica datos.
También conviene revisar las estadísticas antes de concluir que falta un índice. Es un paso de diagnóstico práctico: una consulta lenta puede requerir más investigación que la elección de un índice.
2. Plantea un candidato a partir de los filtros
Anota qué columnas aparecen en condiciones de igualdad, cuáles se filtran por un rango y si la consulta solicita un orden concreto. Consulta también los índices existentes antes de elegir qué probar.
Ejemplo: igualdad y rango
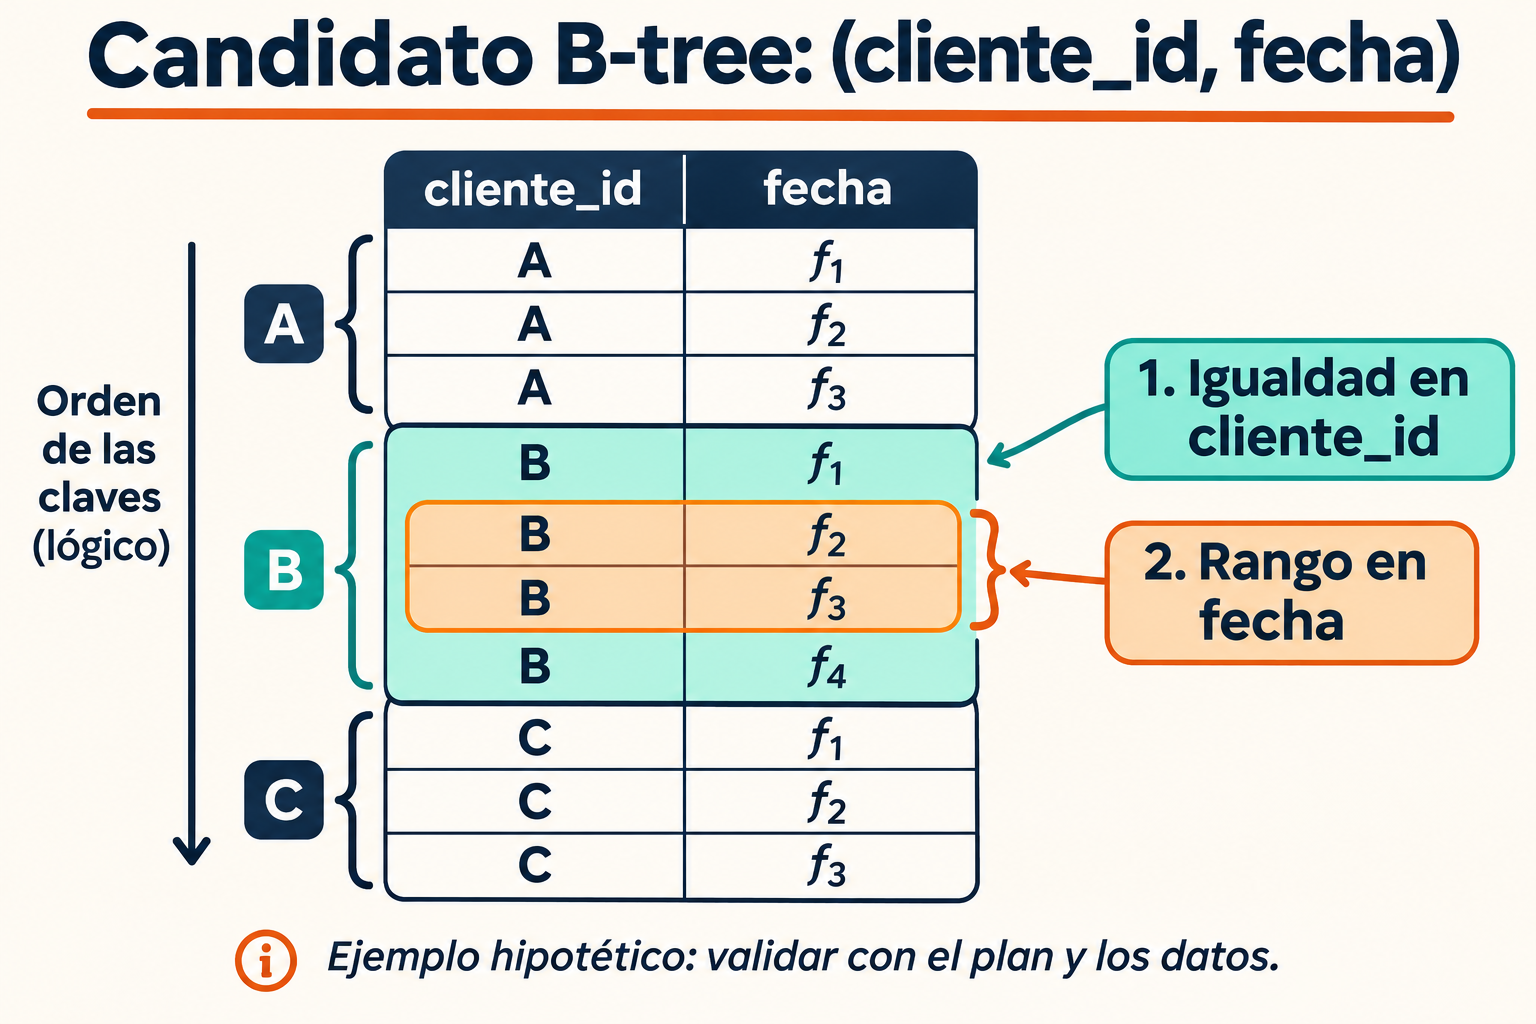
Imagina una consulta que filtra por igualdad en cliente_id y por un rango en fecha. Un B-tree sobre (cliente_id, fecha) es un candidato editorial para medir: la condición de igualdad queda en la columna inicial. La documentación de índices multicolumna trata las igualdades en columnas iniciales. La elección para una consulta real sigue dependiendo del plan y de los datos.
Otros tipos y diseños
El tipo de dato y el operador también orientan la investigación. Por ejemplo, la documentación describe GIN como una opción para valores con múltiples componentes. Si lo consideras para tu consulta, comprueba en esa página la compatibilidad del operador y de la clase correspondiente.
Si el filtro usa una expresión, afecta solo a una parte de las filas o la consulta necesita una ordenación específica, consulta las secciones de PostgreSQL sobre índices sobre expresiones, índices parciales y ordenación con índices. Esos diseños son alternativas que merecen evaluación según la consulta.
3. Prueba y compara
- Registra el plan y el rendimiento de la consulta antes de probar el candidato.
- Prueba el índice con datos y una carga representativos.
- Compara el plan y el rendimiento posteriores, junto con el tamaño del índice y el coste de mantenimiento durante las escrituras.
Esta comparación es una recomendación práctica; ningún candidato garantiza una mejora. Si contemplas CREATE INDEX CONCURRENTLY, revisa sus condiciones en la documentación de CREATE INDEX. La documentación indica expresamente: “a regular CREATE INDEX command can be performed within a transaction block, but CREATE INDEX CONCURRENTLY cannot”. Las demás condiciones de construcción concurrente quedan pendientes de comprobación.
Sin la consulta real, el esquema, la versión instalada, los índices existentes, el plan y la distribución de datos, no es posible recomendar un índice concreto ni cuantificar una mejora. Tampoco se han aportado mediciones de la carga real.
Comentarios
Publicar un comentario